이번글에서는 Spark on K8s 에서 기본 스케줄러 대신 Apache YuniKorn 스케줄러를 사용하기 위해 관련 개념과 동작 방식 등을 자세히 살펴보자.
1. Apache YuniKorn
기본 kube-scheduler는 본질적으로 서비스 중심 스케줄러라 배치 워크로드에 아래와 같은 한계가 존재한다.
- 팀이나 테넌트별로 작업을 대기시키고 자원을 배분하는 계층형 작업 큐를 제공하지 않음
- 모든 워크로드가 클러스터 전체라는 동일한 자원 풀을 공유
- 어플리케이션 개념이 없어 어플리케이션 단위 스케줄링이 불가
- gang scheduling 개념이 없음
- 계층형 큐, 멀티테넌시, 큐별 쿼터 부재
Apache YuniKorn은 기본 K8s 스케줄러를 대체하면서도 계층형 큐, 큐 간 리소스 공정성, 작업 순서 지정(FIFO/FAIR), 노드 정렬 정책, 선점(preemption) 등 더 강력한 스케줄링 기능을 제공하는 것이 핵심이다.
원래는 YARN과 K8s를 모두 겨냥했지만, 현재는 사실상 쿠버네티스 커스텀 스케줄러로 자리잡았다.
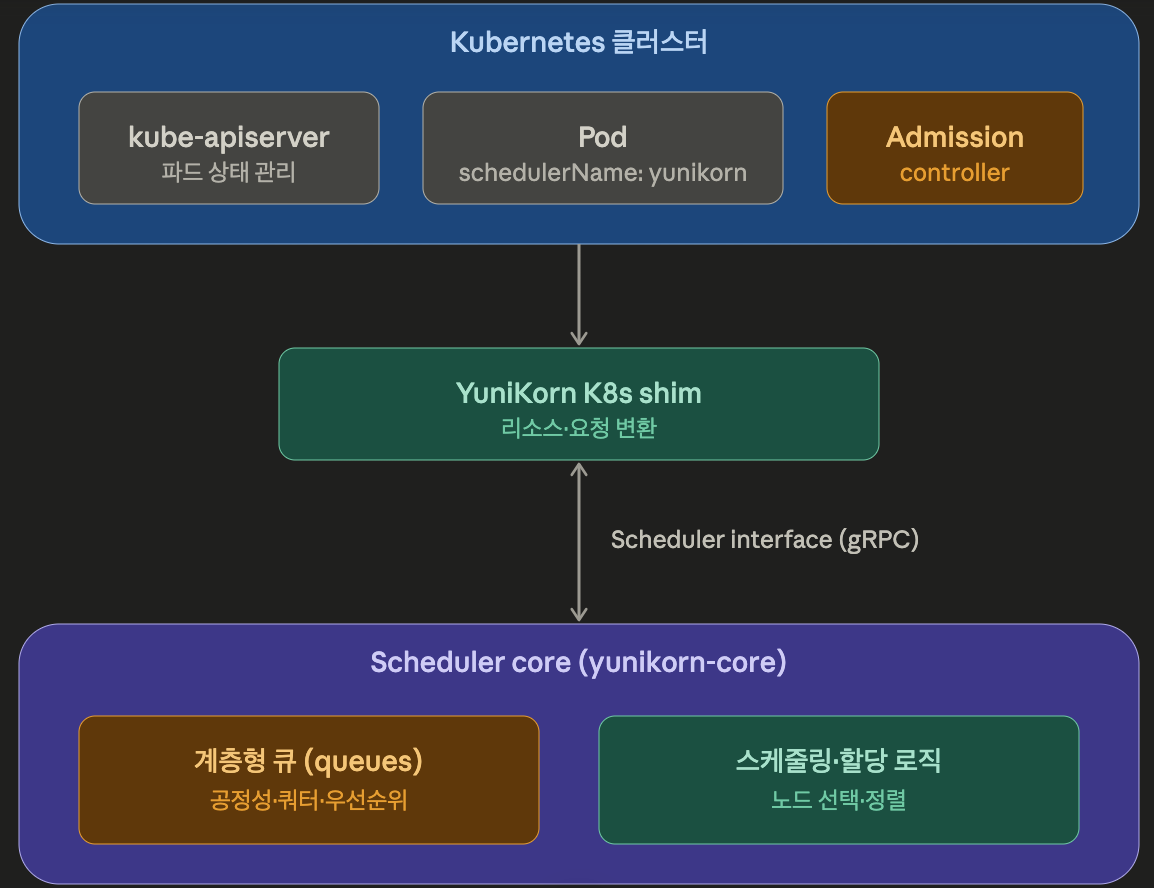
구조의 핵심은 두 컴포넌트로 나뉜다는 점이다. Scheduler core는 모든 스케줄링 알고리즘을 캡슐화하고, 하부 리소스 관리 플랫폼(K8s/YARN)으로부터 리소스를 수집해 컨테이너 할당 요청을 처리한다.
core의 모든 통신은 scheduler interface를 통해 이루어지며, 그 사이를 K8s shim이 연결하는데, shim은 쿠버네티스와 통신하며 클러스터 리소스와 리소스 요청을 scheduler interface 형식으로 번역해 core로 전달한다.
여기서 중요한건 admission controller 이다. 쿠버네티스 파드를 만들면, 그 요청이 곧바로 저장되는게 아니라 api 서버 입구를 한번 거치게 된다.
admission controller 는 바로 그 입구에 있다가, schedulerName: yunikorn을 끼워 넣어 준다.
그래서 클러스터의 모든 파드가 자동으로 YuniKorn으로 라우팅 되며, 아래와 같이 schedulerName을 추가해줄 필요가 없다.
# admission controller가 있을 때 — 입구에서 자동 주입되므로 생략 가능
spec:
  containers:
    - name: my-app
      image: my-app:latest
# admission controller가 없을 때 — 파드마다 직접 지정해야 함
apiVersion: v1
kind: Pod
spec:
  schedulerName: yunikorn      # ← 이걸 깜빡하면 기본 스케줄러로 가버림
  containers:
    - name: my-app
      image: my-app:latest
1-1) 계층형 큐(Hierarchical Queues)
YuniKorn 스케줄링의 중심 개념이며, 큐는 최상단 root 큐 아래에 자식 큐들이 붙은 계층 구조로 조직되며, 각 큐는 자체적인 리소스 보장(guaranteed)과 한도(max)를 가질 수 있다.
조직 구조(팀/테넌트)에 큐를 매핑해서 멀티테넌시와 쿼터를 구현하는게 전형적인 패턴이다.
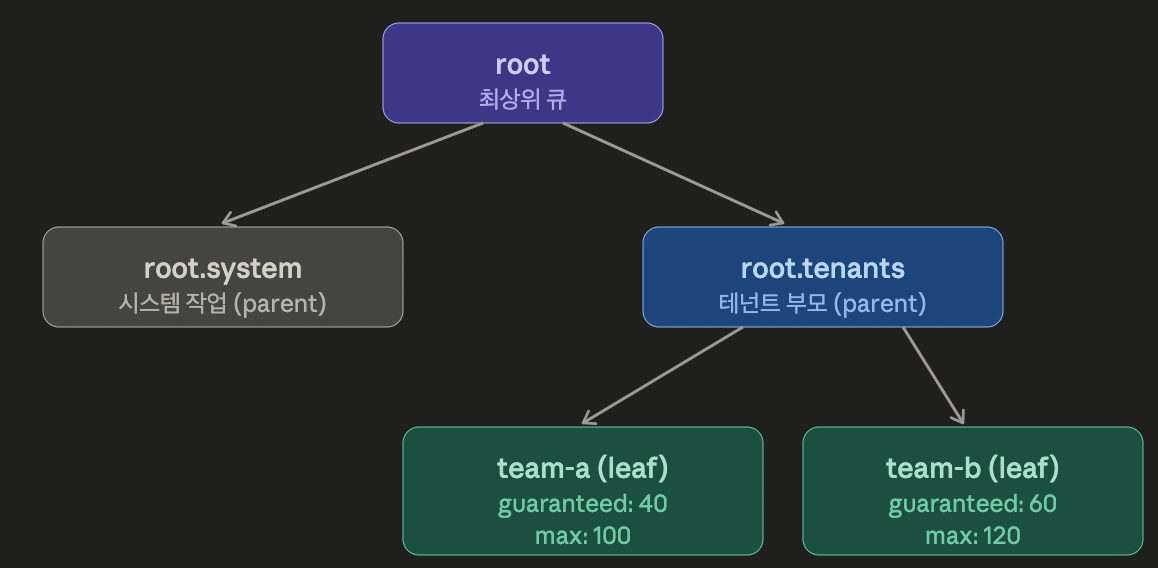
이 구조를 실제로 정의하는 건 yunikorn-configs ConfigMap이다.
기본적으로 스케줄러는 ConfigMap의 queues.yaml 섹션을 읽어 파티션과 큐 설정을 가져온다.
apiVersion: v1
kind: ConfigMap
metadata:
  name: yunikorn-configs
  namespace: yunikorn
data:
  queues.yaml: |
    partitions:
      - name: default
        queues:
          - name: root
            queues:
              - name: system
                parent: true              # leaf를 강제로 parent로 지정
              - name: tenants
                parent: true
                queues:
                  - name: team-a
                    resources:
                      guaranteed: {memory: 40G, vcore: 40}
                      max:        {memory: 100G, vcore: 100}
                    properties:
                      application.sort.policy: fifo
                  - name: team-b
                    resources:
                      guaranteed: {memory: 60G, vcore: 60}
                      max:        {memory: 120G, vcore: 120}
여기서 guaranteed는 최소 보장량이며, 큐의 안전지대이다.
공식 정의상 min-capacity = guaranteed, max-capacity = limit(quota/max)
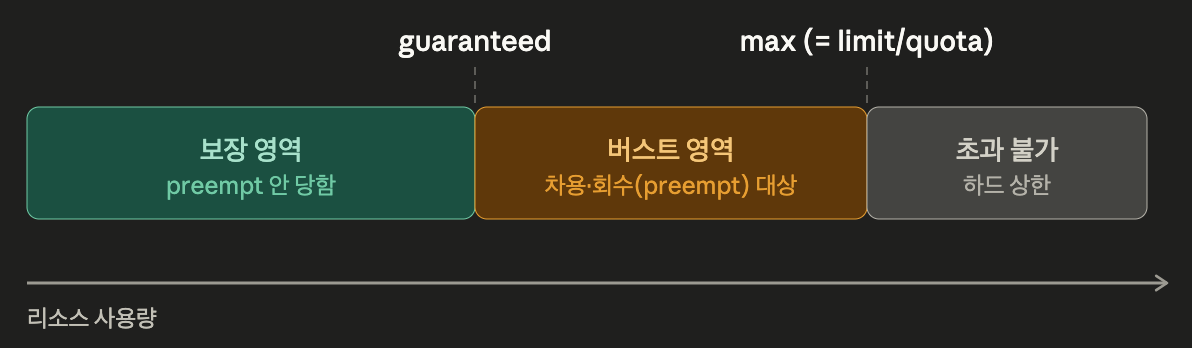
위 그림과 같이 0 ~ guaranteed 영역은 항상 보장되는 영역이며, 선점당하지 않는다.
YARN의 Dedicated queue와 같이 물리적인 리소스를 보장해주는 것이 아니며, 선점으로 대상 큐의 사용량을 guranteed 아래로 낮출 수 없도록 보호 한다.
guaranteed ~ max 영역은 버스트 영역이며, 남는 자원을 빌려 쓸 수 있으나 회수(선점) 대상이 된다.
max 초과는 절대 넘지 못하는 영역이다.
버스트(burst) 영역은 내 몫은 아니지만, 지금 비어있으니 잠깐 빌려 쓰는 구간이다.
예를 들어 team-a가 guaranteed 40 코어, max 100 코어일 때, team-b가 자기 몫을 안 쓰고 놀고 있으면 team-a는 40 코어를 넘어 100 코어까지 빌려 쓸 수 있다.
덕분에 한 팀이 한가할 때 다른 팀이 그 여유를 흡수해서 클러스터 자원이 놀지 않는다.
이것이 각 팀에 자원을 딱 고정해두는 정적 쿼터보다 활용률이 높은 이유다.
다른 큐가 사용하지 않는 자원을 빌려 쓰다가, 해당 큐의 보장량을 충족하기 위해 실행 중인 파드를 종료하고 자원을 회수하는 것을 preemption이라고 한다.
다만 새로운 작업이 들어왔다고 즉시 회수하는 것은 아니며, 일반적인 큐 간 선점은 다음 조건에 따라 동작한다.
먼저, 선점을 요청하는 큐에 실행되지 못한 자원 요청이 있고, 해당 큐의 사용량이 guaranteed에 미달해야 한다.
이미 guaranteed를 충족한 큐는 자신의 사용량을 max까지 늘리기 위해 다른 큐의 자원을 선점할 수 없다.
반대로 회수 대상 큐는 guaranteed를 초과해 사용 중이어야 하며, 파드를 종료한 뒤에도 guaranteed 이상의 자원이 남아야 한다.
예를 들어 guaranteed가 40 코어이고 현재 42 코어를 사용 중이라면, 4코어 짜리 executor를 회수할 경우 38코어가 되므로 해당 executor는 선점 대상으로 선택할 수 없다.
자원 회수는 파드 단위로 이루어지기 때문에 초과 사용량이 있어도 선점이 불가능 할 수 있다.
우선순위 조건도 충족해야 한다.
큐의 우선순위를 별도로 조정하지 않았다면, 우선순위가 100인 요청은 우선순위가 10인 작업을 선점할 수 있지만, 반대 방향으로 선점할 수 없다.
YuniKorn에서는 같은 우선순위의 작업도 선점할수 있다.
본인 queue의 guaranteed가 부족하더라도 더 높은 우선순위의 작업을 종료해서 자원을 가져올 수는 없다.
또한 preemption.policy: fence를 설정하면, 해당 큐와 그 하위 큐의 요청이 선점 대상을 찾을 수 있는 범위를 제한한다.
root
├── system
└── tenants  ← preemption.policy: fence
    ├── team-a
    └── team-b
위 구조에서는 team-a 와 team-b가 서로 선점할 수 있지만, 두 큐의 요청이 tenants 밖의 system 작업을 선점할 수는 없다.
단, 이 fence는 tenants 내부의 요청이 밖으로 나가서 선점하는 것을 제한하는 설정이다.
system 쪽 요청이 tenants 내부의 작업을 선점하는 것까지 차단하지는 않는다.
부모 큐에 fence를 설정해도 그 아래 형제 큐 사이의 선점은 가능하다. 각 leaf 큐에 fence를 설정하면 탐색범위가 해당 leaf 큐로 제한되므로 큐 간 선점이 사실상 차단된다.
선점 전에는 preemption.delay 만큼 대기한다.
기본값은 30초이며, 자원을 기다리는 요청이 선점을 시도하기 전까지의 대기시간이다.
실행 중인 파드를 일정 시간 보호하거나, 버스트 자원의 사용 시간을 제한하는 설정은 아니다.
preemption.delay는 선점을 요청하는 leaf 큐의 properties에 설정한다. 예를 들어 team-b가 자원을 돌려받기 위해 선점을 요청한다면 team-b의 설정이 적용된다.
이 시간 동안 일반 스케줄링으로 자원을 확보할 기회를 주고, 시간이 지난 뒤에도 대기 중이라면 선점을 검토한다.
다만 적절한 회수 대상이 없으면 계속 대기하므로, 설정한 시간 안에 실행된다는 보장은 없다.
preemption은 버스트로 빌려 간 자원을, 원래 보장받아야 할 큐에게 돌려주는 회수 메커니즘이다.
즉, 실행중인 파드 라도 회수 대상이 되면 종료될 수 있다. 다만 아무거나 빼앗는 것이 아니라, 정해진 규칙에 따라 동작한다.
회수는 강제 kill 이 아니라 쿠버네티스 표준 graceful termination 으로 종료한다.
여기서 회수하는 대상(victim 선정) 이 spark driver 라면, 잡 전체가 죽기 때문에 YuniKorn은 아래와 같은 완화 장치를 둔다.
# 드라이버 보호: 선점 회피 요청 + 높은 우선순위
metadata:
  labels:
    applicationId: "spark-prod-001"
  annotations:
    yunikorn.apache.org/allow-preemption: "false" # 선점 회피 요청
spec:
  priorityClassName: spark-prod-high   # prod는 높은 우선순위
allow-preemption: “false”: 는 선점 대상에서 가급적 제외해달라는 요청이며, 절대적인 선점 금지를 보장하지 않는다.
다른 적절한 대상이 없는 상황에서는 선점될 수 있다.
Kubernetes ResourceQuota는 admission 단계에서 Pod 생성 요청이 쿼터를 초과하는지 검사한다.
반면 YuniKorn 큐 max는 스케줄링 단계에서 할당할 자원을 제한하므로, 큐의 자원이 부족한 Pod는 Pending으로 대기할 수 있다.
이때 큐 사용량은 실제 CPU 사용률이 아니라 스케줄러가 할당한 자원량을 기준으로 집계한다. 대기 중인 요청 자원은 할당량으로 집계하지 않는다.
Kubernetes ResourceQuota를 초과하면 새로운 Pod 생성 요청이 거부된다.
이때, Spark 어플리케이션의 경우 강제로 종료될 수 있기 때문에 재처리에 대한 고려도 필요하다. YuniKorn 큐의 자원 제한은 Pod를 Pending으로 대기시킬 수 있지만, Kubernetes ResourceQuota를 함께 사용한다면 admission 단계에서 요청이 거부될 수 있다.
1-2) Placement Rules (큐 자동 배치)
어플리케이션을 큐에 동적으로 배치하는 규칙이며, 제출 시 큐를 명시하지 않아도, 규칙이 앱 정보(사용자명, 태그 등)를 이용해 큐를 결정한다.
placementrules:
  - name: tag
    value: namespace      # 파드의 namespace → 큐 이름
    create: true          # 해당 큐 없으면 자동 생성
1-3) 작업 순서와 공정성 (FIFO / FAIR)
application.sort.policy는 leaf 큐 내부의 어플리케이션 정렬 정책이다.
spark.scheduler.mode와는 서로 다른 설정이다.
기본 설정에서는 우선순위를 먼저 고려하여, 같은 우선순위라면 FIFO 는 먼저 제출한 앱을, FAIR는 자원 사용량이 적은 앱을 먼저 검토한다.
- FIFO: 같은 우선순위라면 먼저 제출한 앱의 자원 요청을 먼저 검토
- FAIR: 같은 우선순위라면 자원 사용량이 적은 앱을 먼저 검토
1-4) Gang Scheduling.
Spark 처럼 여러 파드가 함께 떠야 하는 워크로드의 경우 핵심 기능이며, 드라이버만 떠서 자원을 점유한 채 executor를 못 받으면 교착(resource deadlock)이 생기는데, gang scheduling은 필요한 최소 리소스를 placeholder로 먼저 확보한 뒤 실제 작업을 시작하여 이러한 문제를 줄인다.
다만, 아래 예제의 Soft 방식은 placeholder 확보가 타임아웃되면 일반 스케줄링으로 전환할 수 있다.
Hard 방식은 해당 상황에서 어플리케이션을 실패 처리 한다.
--conf spark.kubernetes.driver.annotation.yunikorn.apache.org/task-groups='[
  {"name": "spark-driver",   "minMember": 1,  "minResource": {"cpu": "1", "memory": "2Gi"}},
  {"name": "spark-executor", "minMember": 10, "minResource": {"cpu": "1", "memory": "2Gi"}}
]'
--conf spark.kubernetes.driver.annotation.yunikorn.apache.org/schedulingPolicyParameters='placeholderTimeoutInSeconds=300 gangSchedulingStyle=Soft'
단, 주의해야할점은 gang 앱이 도는 큐는 FIFO 여야 한다.
FAIR 큐에 gang 앱을 제출하면 거부한다.
FAIR 는 여러 New 어플리케이션을 동시에 할당해 쿼터 관리를 불가능하게 만들고, 부분적으로만 보장된 앱이 여럿 생길 수 있으며, 오토스케일로 늘어난 노드를 placeholder 대신 다른 앱이 가져가 gang이 깨질 수 있기 때문이다.
gang은 필요한 멤버가 한꺼번에 다 모여야 시작하는 방식이고, 이걸 위해 placeholder로 자리를 잡아두고 기다린다. 그런데 FAIR 정렬은 여러 앱을 조금씩 공평하게 동시에 진행시키려는 성격이라 한꺼번에 몰아주기가 필요한 gang과 철학과 다르다.
Gang Scheduling 사용시 FIFO 약점은 큰 잡이 자기 자원을 다 확보하지 못해서 앞에서 대기하느라 뒤에 작은 잡들이 기다리는 상황이 있다.
이를 위한 보완책은 첫번째로 워크로드 별로 큐를 나누는 것이다.
둘때, maxapplications로 한 큐 안에 동시 실행 수를 제한해 동시에 running 상태인 앱의 개수를 제한하는 것이다.
동시에 너무 많은앱이 떠서 자원이 얇게 쪼개지는 것을 막는다.
- name: team-a
  maxapplications: 10          # 이 큐에서 동시에 도는 앱은 최대 10개
  resources:
    guaranteed: {memory: 200G, vcore: 100}
    max:        {memory: 400G, vcore: 200}   # 자원 상한은 여기서 (앱 독점 방지)
  properties:
    application.sort.policy: fifo
Reference
https://spark.apache.org/docs/latest/running-on-kubernetes.html
https://medium.com/@titieiti.com/airflow-kubernetesexecutor%EC%99%80-kubernetespodoperator-19d470e40a1e
https://github.com/fabric8io/kubernetes-client/blob/v6.4.1/kubernetes-client-api/src/main/java/io/fabric8/kubernetes/client/Config.java